大規模言語モデル(LLM)を自社の用途に合わせてファインチューニングしたい......
でも、
GPUが足りない
コストが高すぎる
学習に時間がかかる
そんな理由であきらめていませんか?
実は今、LoRA(Low-Rank Adaptation)やQLoRA(Quantized LoRA)といった新しい技術の登場により、RTX 3090や4090などのコンシューマーGPUでも、Metaの最新モデル「LLaMA 3」を効率よくファインチューニングできる時代が来ています。
この記事では、LLaMA 3を対象に、少ないリソースで高品質なモデルを構築するためのLoRA / QLoRA活用術を、RabilooのAIエンジニアがコード付きで徹底解説します。
LoRA / QLoRAとは?どんなメリットがある?
LLaMA 3の特徴と、なぜ相性が良いのか
実装手順:コード付きでLoRA / QLoRAを適用
実験結果:LoRA vs QLoRAの精度・メモリ比較
選び方ガイド:自分に合うファインチューニング方法は?
ファインチューニングの壁とPEFTの登場
GPTなどの大規模言語モデル(LLM)は汎用的な能力を備えていますが、特定の業務や領域に最適化するには限界があります。ファインチューニングは、既存モデルにドメイン固有の知識や文脈を追加学習させ、実用性と精度を高めるための手法です。
しかし従来のフルファインチューニングは、
A100などの高性能GPU(80GB以上)
長時間のトレーニング
数百万円規模のコスト
が必要で、個人や中小企業には手が届きませんでした。
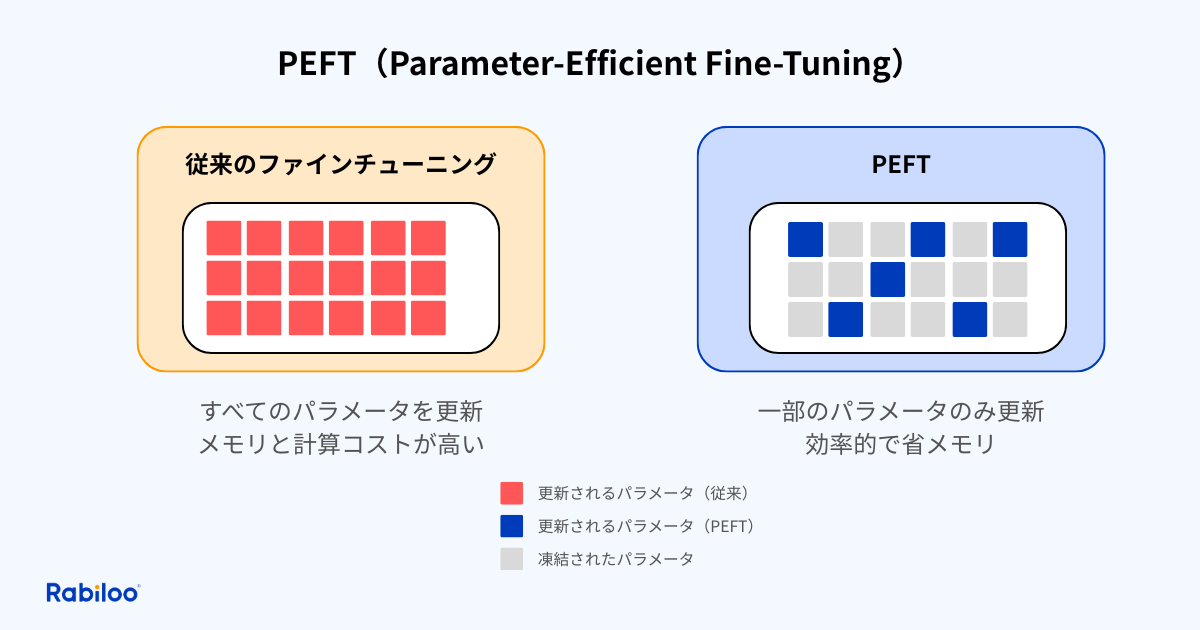
そこで登場したのが、PEFT(Parameter-Efficient Fine-Tuning)という手法です。モデル全体ではなく一部パラメータのみを更新することで、効率よく学習が可能になります。
特に注目されているのが、
LoRA(Low-Rank Adaptation)
QLoRA(Quantized LoRA)
の2つの手法です。
LoRA / QLoRAとは?仕組みと特徴
LoRA(Low-Rank Adaptation)とQLoRA(Quantized LoRA)は、PEFT(Parameter-Efficient Fine-Tuning)手法の代表例であり、モデル全体を再学習せず一部のパラメータだけを効率的に更新する技術です。これにより、高性能な大規模モデルを少ないGPUリソースでチューニングできるようになります。
LoRAとは?
LoRAは、既存の重み行列に対して低ランク行列(AとB)を挿入し、W' = W + A @ B の形で表現することで、学習対象を数百万パラメータに抑えながらファインチューニングを実現します。元の重みWは固定されたままで、AとBのみを学習します。
LoRAは「Low-Rank Adaptation(低ランク適応)」の略で、事前学習済みの大規模モデルを効率的に調整するための手法です。その核となる考え方は、モデルの重み行列の変化(ΔW)を低ランク行列の積として表現することです。
ニューラルネットワークには行列積を実行する複数の密な層が含まれており、これらの層の重み行列は通常フルランクです。Aghajanyan(2020)の研究によると、事前学習済み言語モデルには「固有の次元」があり、ファインチューニング時にも元のモデルよりも低い次元で表現できることが示されています。
LoRAの仕組みを数学的に説明すると以下のようになります:
事前学習された重み行列 W ∈ R(d×k) に対して、重みの変化 ΔW を低ランク行列分解で表現します
具体的には、W + ΔW = W + BA という形で分解します
ここで B ∈ R(d×r)、A ∈ R(r×k)、ランク r << min(d, k) です
トレーニング中、元の重み W は凍結され更新されません
行列 A はガウス分布で初期化され、行列 B はゼロで初期化されます
これにより次の出力が得られます。
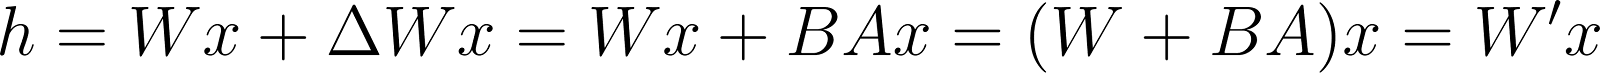
上記の式から、出力は影響を受けず、LoRA によるトレーニング後の推論時間も影響を受けないことがわかります。行列ΔW を2 つの行列AとBに分解すると、なぜ計算量が減るのでしょうか?
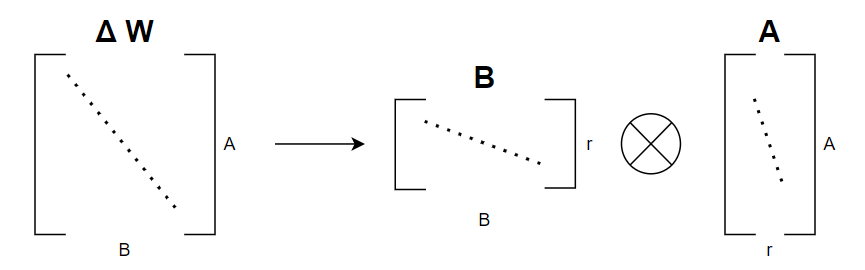
この方法の最大のメリットは、ΔW 行列を2つの小さな行列 A と B に分解することで、パラメータ数を大幅に削減できる点です。例えば、元の行列が1000×1000の場合、100万のパラメータが必要ですが、r=10のLoRA分解では、B(1000×10)とA(10×1000)で合計2万パラメータのみで済みます。これは元のパラメータ数の2%に過ぎません。
現在のLoRA実装では、線形層(Linear layer)の重みのみを分解対象としており、他の層には適用されません。これによりさらに効率化が図られています。
メリット:学習が高速で安定、高精度を保ちやすい
デメリット:モデル全体はフル精度のままなので、VRAMがやや必要(例:16GB以上)
QLoRAとは?
QLoRAはLoRAの発展系で、さらにベースモデルを4bitに量子化してGPUメモリ使用量を削減します。QLoRAは「Quantized LoRA」の略で、量子化(Quantization)とLoRAを組み合わせた手法になります。量子化処理により、より小さなGPU(例:RTX 3060など)でも大規模モデルのチューニングが可能です。
QLoRAの特徴:
NF4(Normal Float 4) - 通常のInt4やFloat4データ型と比較して、わずか4ビットでより高い精度を提供する新しいデータ型です。
二重量子化(Double Quantization) - 量子化された値を再度量子化することで、さらにメモリ使用量を削減します。
ページングオプティマイザ(Paged Optimizers) - GPUのメモリ不足(OOM)エラーを回避するため、一時的にCPUメモリにデータを移動させる技術です。GPUが計算に必要な際には、CPUからデータを取り出して処理を行います。
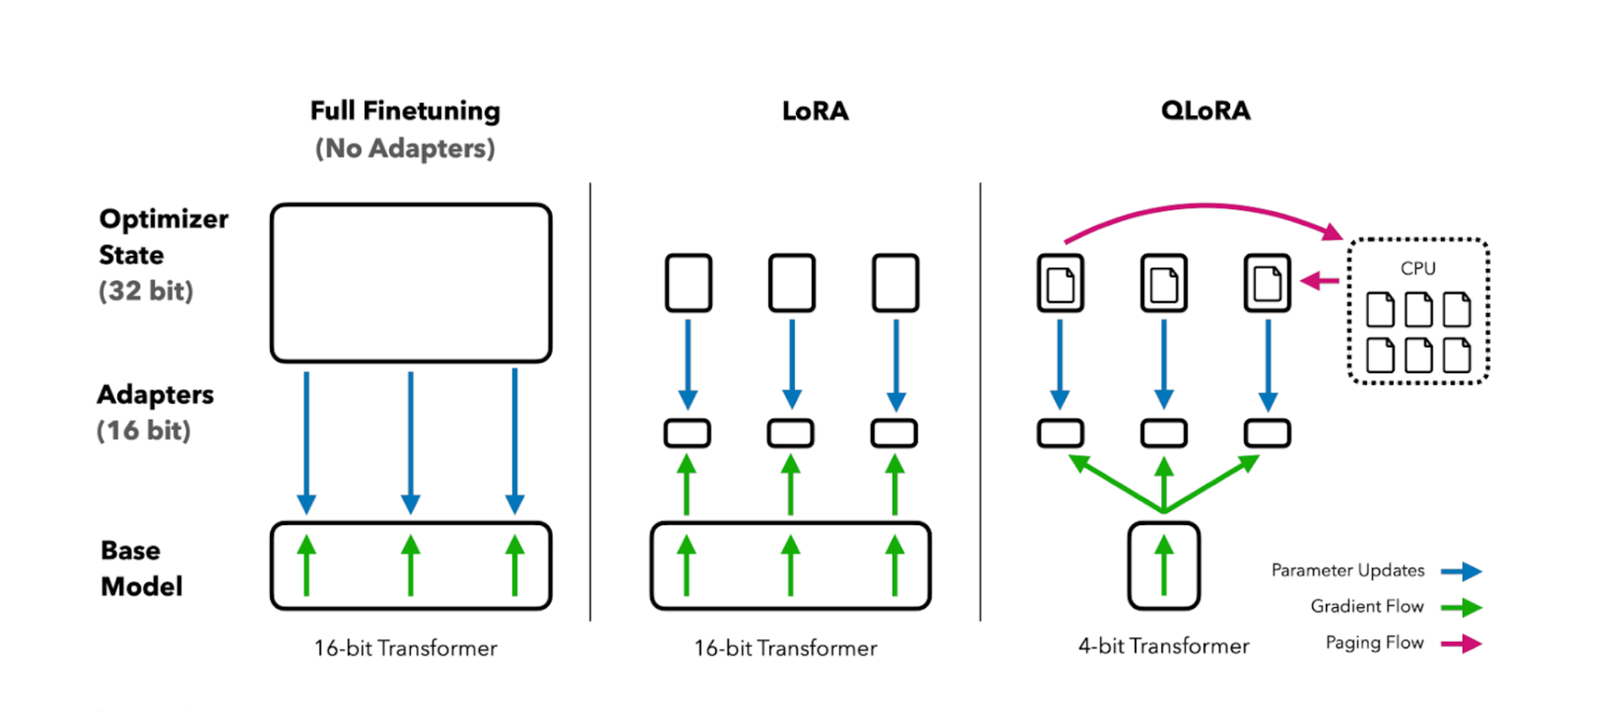
QLoRAの処理フローは以下のようになります:
事前学習部分の重みをNF4に量子化します
計算時には、事前学習部分をNF4からBF16に逆量子化します
BF16形式のLoRA部分と組み合わせて計算を行います
計算後、事前学習部分を再びNF4に量子化してメモリに格納します
この方法により、QLoRAはGPUのVRAMにモデルを収めながらトレーニングを可能にします。ただし、計算のたびに逆量子化が必要なため、LoRAに比べて訓練速度は遅くなるデメリットがあります。
メリット:圧倒的な省メモリ性能(6〜8GBで動作)
デメリット:学習速度はやや低下し、実装も複雑
LoRA vs QLoRA:特徴と違い
LoRA と QLoRAの違いを表にまとめました。
項目 | LoRA | QLoRA |
|---|---|---|
精度 | フル精度で高い | ほぼ同等(やや劣化可能性) |
GPUメモリ | 多め(16GB以上推奨) | 少なめ(6〜8GBでも可) |
学習速度 | 速い | やや遅い(量子化処理あり) |
実装の手軽さ | シンプル | やや複雑(bitsandbytes必要) |
向いている人 | 高精度を重視する層 | GPUリソースが限られている層 |
どちらも、モデル全体を更新せずに一部のパラメータだけを効率よく学習させる技術ですが、細かな違いがあります。
どっちを選べばいいのか迷う人も多いのではないでしょうか?
結論から言えば、選び方のポイントは以下のようになります:
「GPUのメモリに余裕があるならLoRA」
「限られたGPUで大きなモデルを動かしたいならQLoRA」
実装ライブラリとツール
LoRAとQLoRAの実装は、以下のような主要なライブラリとツールを通じて利用できます:
Hugging Face PEFT(Parameter-Efficient Fine-Tuning)ライブラリ - LoRAを含む複数のパラメータ効率的なファインチューニング手法を提供する使いやすいライブラリです。
bitsandbytes - 量子化技術を提供するライブラリで、QLoRAの実装に不可欠です。PEFTと併用することで、効率的なQLoRAファインチューニングが可能になります。
Hugging Face TRL(Transformer Reinforcement Learning)ライブラリ - LoRAを使った教師付きファインチューニングに便利なトレーナーを提供します。
LLaMA-Factory - 大規模言語モデルのトレーニングに広く使用されるフレームワークで、LoRAとQLoRAをサポートしています。このツールは、特に初心者にとってファインチューニングプロセスを簡素化します。
これらのライブラリを組み合わせることで、選択した事前訓練済みモデルを効率的にファインチューニングし、指示に基づいて一貫性のある説得力のある製品説明を生成できるようになります。LoRAとQLoRAの革新的なアプローチにより、一般的なGPUでも効率的にLLaMA 3のようなモデルをカスタマイズすることが可能になりました。
LLaMA 3とは?なぜLoRA / QLoRAと相性がいいのか
LoRAやQLoRAを活用してファインチューニングするなら、どの大規模言語モデル(LLM)を選ぶべきか?
その選択肢の一つとして、今注目を集めているのがMeta社の「LLaMA 3」シリーズです。ここでは、LLaMA 3の基本的な特性を整理しながら、他のLLMと比べてどのような強みがあるのか、なぜファインチューニングの対象として選ばれているのかを見ていきましょう。
Meta(旧Facebook)が開発したLLaMA(Large Language Model Meta AI)シリーズは、オープンウェイトで提供されている大規模言語モデルです。
その最新版である「LLaMA 3」は、2024年に登場し、性能と柔軟性を両立した注目のモデルとして急速に広まりました。
LLaMA 3の特長
モデルサイズ:1B / 8B / 13B / 70B
提供形態:オープンウェイト(商用利用も条件付きで可)
NLPタスク全般に対応(翻訳・要約・チャット・コード生成)
長文コンテキスト対応(数千トークン)
GPT-4やClaude 3とどう違う?
モデル | 提供元 | オープン性 | 商用利用 | 精度 | カスタマイズ性 |
|---|---|---|---|---|---|
LLaMA 3 | Meta | ✅ オープンウェイト | ✅ 条件付き可 | 非常に高い | ✅ 可(LoRA / QLoRA対応) |
GPT-4 | OpenAI | ❌ クローズドAPI | ⭕ API経由で可 | 非常に高い | ❌ 不可(自前学習できない) |
Claude 3 | Anthropic | ❌ クローズドAPI | ⭕ API経由で可 | 高い | ❌ 不可 |
Mistral / Mixtral | Mistral | ✅ オープン | ✅ 可 | 高い | ✅ 可 |
Gemini 1.5 | Google DeepMind | ❌ クローズドAPI | ⭕ API経由で可 | 高い | ❌ 不可 |
特にGPT-4やClaude 3は商用利用では強力な選択肢ですが、自社データでの独自ファインチューニングやエッジ環境での活用は不可能です。これがLLaMA 3の大きな差別化ポイントになります。
「自社データでLLMを強化したい」「クラウドに依存せずにモデルを扱いたい」——そんなニーズに応えてくれるのが、オープンで柔軟性の高いLLaMA 3です。
オープンウェイトモデルのメリット
LLaMA 3の最大の特徴の一つは、「オープンウェイト」モデルであることです。これは、モデルの重み(パラメータ)が公開されており、一定の条件下で研究や商業利用に活用できることを意味します。この特性がもたらす主なメリットには以下のようなものがあります:
透明性と検証可能性 - モデルの内部構造や挙動を詳細に調査・分析できるため、信頼性の高いAIシステムの構築に役立ちます。
カスタマイズの自由度 - 企業や開発者は自社の特定ニーズに合わせてモデルを調整できます。これにより、特定のドメインや用途に特化した高性能なAIソリューションの開発が可能になります。
コスト効率 - API呼び出しベースのクローズドモデルと比較して、長期的にはコスト効率が高いケースが多いです。特に大量のリクエストを処理する必要があるアプリケーションでは顕著です。
知的財産権の制御 - 自社データでファインチューニングしたモデルの知的財産権を保持できるため、競争上の優位性を確保しやすくなります。
オフライン実行の可能性 - インターネット接続に依存せずにモデルを実行できるため、プライバシーが重要な用途やネットワーク接続が限られた環境でも利用可能です。
これらの理由から、LLaMA 3は特に企業向けの実用的なAIソリューション開発において、魅力的な選択肢となっています。GPT-4のような閉じたシステムとして動作するプロプライエタリモデルとは異なり、LLaMA 3は特定のアプリケーションのためにカスタマイズする柔軟性を提供します。
相性の理由
オープンなので自由にファインチューニングできる
小〜中規模モデル(1B〜13B)でも高性能
OSS(オープンソースソフトウェア)コミュニティが活発(Hugging Face、LLaMA-Factory等)
次は、このモデルに対して実際にLoRA / QLoRAを適用する方法を、具体的なコード付きで紹介します。
LLaMA 3をLoRA / QLoRAでファインチューニングする手順
ここからは、実際にLLaMA 3をLoRAまたはQLoRAでファインチューニングする方法を、コードと一緒にステップ・バイ・ステップで解説していきます。
使うツールは、LLaMA系モデルのトレーニングに特化したオープンソースフレームワーク「LLaMA-Factory」です。LoRAとQLoRAの両方に対応しており、Hugging Faceベースで手軽に扱えるのが特長です。
ステップ1:環境の準備
まず、必要な環境をセットアップするところから始めましょう。以下のコマンドを使用して、LLaMA-Factoryをインストールします:
git clone --depth 1 <https://github.com/hiyouga/LLaMA-Factory.git>
cd LLaMA-Factory
pip install -e ".[torch,metrics]"
このコマンドは、LLaMA-Factoryリポジトリをクローンし、PyTorch関連の依存関係とメトリクス評価ツールをインストールします。LLaMA-Factoryは、モデルのファインチューニングと評価を容易にする包括的なフレームワークを提供します。
セットアップが完了したら、ファインチューニングに必要なGPUドライバとCUDAのバージョンが正しくインストールされていることを確認しましょう。NVIDIA GPU使用時は、nvidia-smiコマンドでGPUの状態とドライバのバージョンを確認できます。
ステップ2:データの準備
ファインチューニングには、目的に適したデータセットが必要です。本例では、Hugging Faceが提供する公開データセット「BillSum」を使用します。このデータセットは、米国の法案を要約するためのデータセットです。
LLaMA-Factoryでは、データは特定のフォーマットに整形する必要があります。以下はフォーマット済みデータの例です:
{
    "instruction": "Summary of the following paragraph",
    "input": "SECTION 1. SHORT TITLE.\\n\\n    This Act may be cited as the ``Merchant Marine of World War II \\nCongressional Gold Medal Act''.\\n\\nSEC. 2. FINDINGS.\\n\\n    The Congress finds the following:\\n            (1) 2015 marks the 70th anniversary of the Allied victory \\n        in World War II and the restoration of peacetime across the \\n        European and Pacific theaters.\\n           (3) Fleet Admiral Ernest J. King acknowledged the \\n        indispensability of the Merchant Marine to the victory in a \\n        1945 letter stating that without their support, ``the Navy \\n        could not have accomplished its mission''...",
    "output": ".  Merchant Marine of World War II Congressional Gold Medal Act (Sec. 3) This bill requires the Speaker of the House of Representatives and the President pro tempore of the Senate to arrange for the award, on behalf of Congress, of a single gold medal to the U.S. Merchant Marine of World War II, in recognition of their dedicated and vital service during World War II.  Following its award the medal shall be given to the American Merchant Marine Museum where it will be available for display and research."
}
フォーマットされたデータはdata/summarization_data_train.jsonに保存します。また、data/dataset_info.jsonファイルにデータセットの説明を追加し、トレーニング前にdataset: dataset_nameを指定する必要があります。例えば:
{
 "summarization_data_train": {
   "file_name": "summarization_data_train.json"
 }
}
データセットの準備方法について詳しくは、LLaMA-Factoryの公式ドキュメントを参照してください。
ステップ3:設定ファイルの作成(YAML)
次に、ファインチューニングの設定ファイルを作成します。設定ファイルには、モデルパス、LoRAの設定、データセット情報、トレーニングパラメータなどが含まれます。
examples/train_lora/llama3_lora_sft.yamlというファイルを作成し、以下の内容を記述します:
### model
model_name_or_path: meta-llama/Llama-3.2-1B-Instruct
trust_remote_code: true

### method
stage: sft
do_train: true
finetuning_type: lora
lora_rank: 8
lora_target: all

### dataset
dataset: summarization_data_train
template: llama3
cutoff_len: 2048
max_samples: 1000
overwrite_cache: true
preprocessing_num_workers: 16

### output
output_dir: saves/llama3.2-1b-instruct/lora/sft
logging_steps: 2
save_steps: 50
plot_loss: true
overwrite_output_dir: true

### train
per_device_train_batch_size: 4
gradient_accumulation_steps: 8
learning_rate: 1.0e-4
num_train_epochs: 1.0
lr_scheduler_type: cosine
warmup_ratio: 0.1
bf16: true
ddp_timeout: 180000000

## eval
val_size: 0.1
per_device_eval_batch_size: 1
eval_strategy: steps
eval_steps: 50
この設定ファイルの主なパラメータについて説明します:
model_name_or_path: モデルのHugging Faceリポジトリパスstage: モデルトレーニングフェーズ(ここでは教師付きファインチューニング)finetuning_type: LoRAトレーニングlora_rank: LoRAの内在ランク(r値)lora_target: LoRAを適用するモジュール(allは全線形層)dataset: データセット名template: モデルテンプレートper_device_train_batch_size: 1デバイスあたりのトレーニングバッチサイズ
ステップ4:トレーニングの実行
以下のコマンドを使用してファインチューニングを開始します:
llamafactory-cli train examples/train_lora/llama3_lora_sft.yaml
実行中はログに損失(loss)の推移が表示され、トレーニングの進行状況を監視できます。ファインチューニングされたモデルはsaves/llama3.2-1b-instruct/lora/sftディレクトリに保存されます。
ステップ5:LoRAのマージ(本番用モデルの出力)
ファインチューニング完了後、モデルの評価を行います。評価のために、LoRAアダプタを元のモデルにマージする必要があります。以下の設定ファイルexamples/merge_lora/llama3_lora_sft.yamlを作成します:
### model
model_name_or_path: meta-llama/Llama-3.2-1B-Instruct
adapter_name_or_path: saves/llama3.2-1b-instruct/lora/sft
template: llama3
trust_remote_code: true

### export
export_dir: output/llama3
export_size: 5
export_device: cpu
export_legacy_format: false
以下のコマンドでLoRAをマージします:
llamafactory-cli export examples/merge_lora/llama3_lora_sft.yaml
モデルパフォーマンスの評価は、BLEU-4およびROUGEメトリクスを使用して行います。これらのメトリクスは、自然言語処理タスクで一般的に使用される評価指標です。
QLoRAに切り替えたい場合は?
上記設定のうち以下のように変更するだけでQLoRAに対応可能です:
finetuning_type: qlora
bnb_4bit_quant_type: nf4
bnb_4bit_use_double_quant: true
bnb_4bit_compute_dtype: bfloat16
また、bitsandbytesパッケージが必要なので、以下をインストールしておきましょう:
pip install bitsandbytes
次のセクションでは、実際にファインチューニングしたモデルのパフォーマンスがどれほど改善されたのか、評価指標を用いて比較・解説していきます。
LoRAとQLoRAでどれだけ精度が変わる? 実験結果を比較
ここでは、LoRAとQLoRAを使ってLLaMA 3(1Bモデル)をファインチューニングした際に得られた、実際の評価結果を紹介します。
実験の概要
モデル:
meta-llama/Llama-3.2-1B-Instructデータセット:BillSum(法案の要約タスク)
GPU:NVIDIA RTX 3090(VRAM 24GB)
比較方法:
ファインチューニング前(元のモデル)
LoRA(ランクr=8, 全線形層対象)
QLoRA(4ビット量子化、同じ条件)
評価には、自然言語生成でよく使われるBLEU-4と**ROUGE(1/2/L)**を使用しました。
評価結果の比較
モデル | BLEU-4 | ROUGE-1 | ROUGE-2 | ROUGE-L | LoRA Rank | GPUメモリ |
|---|---|---|---|---|---|---|
ファインチューニング前 | 11.92 | 26.17 | 8.67 | 15.19 | - | - |
LoRA(r=8) | 19.64 | 44.20 | 27.67 | 31.40 | 8 | 16GB |
QLoRA(r=8) | 19.87 | 44.45 | 27.97 | 31.64 | 8 | 6GB |
どう読み取ればいい?
LoRAでも大幅に精度が向上しており、ファインチューニングの効果は一目瞭然です。
QLoRAは、精度はほぼ同等か、わずかに上回る程度。にもかかわらず、必要なGPUメモリは10GBも少ない(16GBから6GB)という驚きの結果です。
BLEU-4やROUGE-2といった「文章の一貫性・情報量の再現」に関する指標で、大きな差が出ており、モデルが要約タスクにしっかり適応したことが分かります。
さらに比較したLoRA構成(同一GPUでの実験)
設定 | 更新パラメータ数 | BLEU-4 | ROUGE-L | GPUメモリ |
|---|---|---|---|---|
LoRA r=8(全線形層) | 約560万 | 14.44 | 22.51 | 16GB |
LoRA r=16(全線形層) | 約1127万 | 17.82 | 29.10 | 18GB |
LoRA r=8(q_proj, v_projのみ) | 約85万 | 14.24 | 20.58 | 16GB |
このように、LoRAの「ランク(r)」や適用する層の選び方によっても、メモリ使用量や精度が変化することが確認できました。
所感:コストと性能のバランス
ポイント | 所感 |
|---|---|
LoRA(フル精度) | 高速&高精度だが、16GB以上のGPUがほぼ必須 |
QLoRA(量子化) | メモリ節約に圧倒的有利。低スペック環境での実用化が可能 |
どちらもPEFTとして有効 | タスクに応じたカスタムモデル作成に非常に適している |
まとめ:ファインチューニングすべき?
結論:少しのデータとGPUがあれば、LLaMA 3を十分にカスタマイズ可能。
LoRA / QLoRA のどちらを使っても、事前学習済みモデルに比べて圧倒的に高い精度が得られます。
LoRAとQLoRA、どちらを選ぶべき?目的と環境から考える最適な選択ガイド
ここまで読んで、「LoRAもQLoRAも良さそうだけど、結局どっちを使えばいいの?」と感じた方も多いと思います。
選び方はシンプルに言うと、以下の2点に注目すればOKです:
どのくらいのGPUリソースが使えるか?
どのくらいの精度・スピードが必要か?
それぞれの特徴を踏まえて、目的別におすすめの使い方を見ていきましょう。
1. ハードウェア別のおすすめ手法
あなたのGPU環境 | おすすめの手法 | 理由 |
|---|---|---|
VRAM 16GB以上(RTX 3090, A100など) | ✅ LoRA | 精度重視・高速学習が可能 |
VRAM 6〜12GB(RTX 3060, 4060など) | ✅ QLoRA | 省メモリで大規模モデルも扱える |
ノートPCやクラウドの制限付きGPU | ✅ QLoRA | 低スペックでもファインチューニングが可能 |
QLoRAは4ビット量子化によるメモリ削減により、10倍以上のメモリ効率が得られるケースもあるため、「使えるGPUメモリが少ない」環境ではQLoRA一択といえます。
2. タスク・精度別の選び方
使用目的 | おすすめ | 補足 |
|---|---|---|
高精度な業務用AI(法律、医療、金融など) | ✅ LoRA | フル精度で安定した学習が可能 |
実験・研究、MVP開発 | ✅ QLoRA | 少ないコストで繰り返し試せる |
チャットボット・FAQ自動応答 | どちらもOK | データ量と精度要求次第で選択可 |
長文生成や要約タスク | ✅ QLoRA(13B以上のモデルを使うなら) | モデルサイズが大きくなるため、省メモリが有利 |
実際の選択例(ケーススタディ)
ケース1:中小企業で業務マニュアルの要約AIを作りたい
使用GPU:RTX 3080(10GB)
精度:ほどほどでOK
→ QLoRAがおすすめ。LoRAだとVRAMが足りない可能性あり
ケース2:研究機関で法務文書向けに精度検証を行いたい
使用GPU:A100(80GB)
精度:非常に重要
→ LoRAでフル精度の安定トレーニングが可能
ケース3:プロダクトの初期段階で大量に試したい
使用GPU:RTX 4070(12GB)
→ QLoRAで軽量に検証し、あとでLoRAに切り替えるのが◎
決めきれないときの選び方
まずはQLoRAで動かしてみて、GPUや精度に余裕があればLoRAに切り替えるのがおすすめです。
どちらもHugging FaceのPEFTライブラリでほぼ同じ方法で実装できるため、途中で切り替えても大きな手間はかかりません。
まとめ:限られたリソースでも、実用的なAIを
LoRAやQLoRAは、大規模モデルのファインチューニングを一部のパラメータだけに絞ることで、計算負荷とコストを大幅に削減できる革新的な手法です。これにより、GPUや予算に限りがあるチームでも、業務に最適化された高精度AIを構築することが現実的になってきました。
Rabilooでは、これらの効率的なファインチューニング技術を活用し、クライアントの事業課題に合わせたAIモデルの設計・開発をサポートしています。特定の業務データや独自ルールを反映したAIが必要な場合でも、軽量かつ実用的なアプローチで成果につなげることが可能です。
「自社データを活かしたAIを開発したい」「クラウドに頼らずローカル環境でLLMモデルを運用したい」といったニーズがあれば、LoRAやQLoRAは強力な選択肢になります。
AI開発はぜひ、Rabilooまでお気軽にご相談ください。