「ChatGPTのような高度なAIをローカルマシンで動かすことはできないのか?」
クラウドのAPIに依存せず、自分のデバイスだけでLLM(大規模言語モデル)を動かしたいというニーズはありませんか?
結論から申し上げると、Ollamaを使えばわずか数ステップで高性能なLLMをローカル環境で動かすことが可能です。
実は、クラウドサービスに頼らずとも、適切なツールとセットアップがあれば、プライバシーを確保しながら柔軟にAIモデルを使うことができるのです。
この記事ではRabilooの優秀なAIエンジニアチームが、Ollama(オラマ)というツールを使ってLLMをローカルで動かすための実践的な手順と知識をご紹介します。
RabilooのGitHub リポジトリは https://github.com/rabiloo/llm-on-local で公開されています。このリポジトリをクローンし、付属の指示に従って進めるか、あるいはご自身のニーズに合わせてベストプラクティスを参考にカスタマイズすることができます。
LLMをローカルで動かすメリットとデメリット
Ollamaのセットアップ方法と基本的な使い方
ローカルLLMの活用事例と応用例
必要なハードウェア要件と最適化のコツ
なぜLLMをローカルで動かすのか?そのメリットとデメリット
LLM(大規模言語モデル)は、ChatGPTやGeminiなどの形で一般に普及し、さまざまな分野で活用されています。通常、これらのAIはクラウドサービスとして提供され、インターネット経由で利用されます。
しかし近年、
プライバシー保護
コスト削減
カスタマイズ性の向上
といった理由から、クラウドではなく「ローカル」でLLMを動かすニーズが高まっています。
ローカルLLMとは何か?
ローカルLLMとは、クラウドを介さず、自分のPCや企業のオンプレミス環境で実行する大規模言語モデルのことを指します。通常、ChatGPTやGeminiなどのLLMはインターネット経由でクラウドサービスとして提供されますが、ローカルLLMなら外部サーバーにデータを送信せずに利用できます。
では、クラウドLLMとローカルLLMの違いは何なのでしょうか?
LLMにおけるクラウドとローカル環境の違い
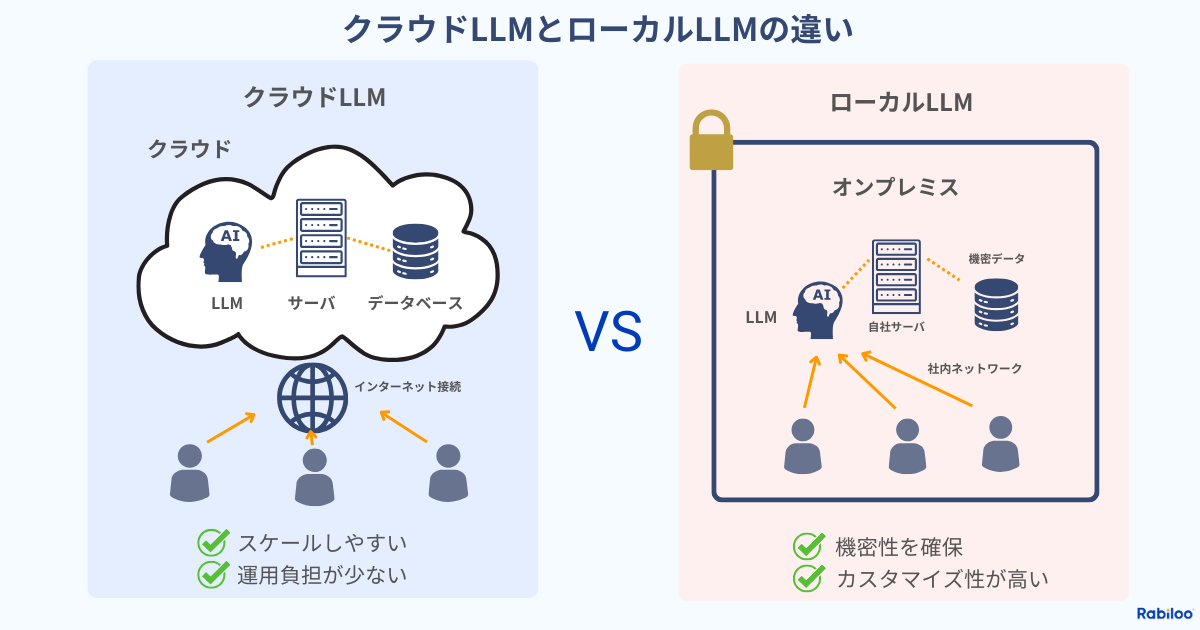
LLM(大規模言語モデル)は、クラウド環境とローカル環境のどちらでも実行できますが、それぞれに明確な違いがあります。
クラウドLLMは、インターネット経由で利用でき、常に最新のモデルを手軽に使えるのが特徴です。大規模な計算リソースを活用できるため高性能ですが、データが外部サーバーに送信されるため、プライバシーの懸念があり、利用量に応じたコストが発生します。
一方、ローカルLLMは、自分のPCや企業内サーバーでモデルを実行するため、データの外部送信を防ぎ、カスタマイズの自由度が高いのが強みです。オフラインでも利用でき、長期的なコストを抑えられますが、高性能なハードウェアが必要で、運用管理の負担が発生する点には注意が必要です。
クラウドは手軽さと高性能を、ローカルはデータ管理と柔軟性を重視する場面に適しており、用途に応じた選択が求められます。
項目 | 従来のLLM(クラウドAPI) | ローカルLLM |
|---|---|---|
データの扱い | クラウドに送信(外部処理) | 社内で完結(内部処理) |
カスタマイズ性 | APIの範囲内で利用 | フルカスタマイズ可能 |
コスト | APIコールごとに従量課金 | 初期投資あり、長期的には低コスト |
応答速度 | ネットワーク遅延あり | 高速(ローカル環境次第) |
セキュリティ | データ漏洩リスクあり | 社内完結で安全性が高い |
モデルの選択 | 事前に学習済みのものを利用 | 企業独自のデータで微調整可能 |
運用の難易度 | 簡単(APIを呼び出すだけ) | サーバー管理・モデル運用が必要 |
クラウドLLMは手軽に利用できる一方、データの外部送信やコスト増大のリスクがあります。ローカルLLMは管理負担があるものの、プライバシー保護や長期的なコスト削減、カスタマイズの自由度に優れています。用途に応じて最適な選択をすることが重要です。
ローカルでLLMを動かすメリット
ローカル環境でLLMを動かすことには、いくつかの明確なメリットがあります。
プライバシーとセキュリティの強化
データ漏洩リスクの低減: 機密情報や個人情報を外部サーバーに送信せずに処理できます
コンプライアンス対応: GDPR、HIPAA、PCI DSSなどの厳格な規制がある業界での利用が容易になります
社内情報の保護: 企業の機密データを社内ネットワーク内で安全に処理できます
カスタマイズと柔軟性
特定用途への最適化: 業界や組織特有のニーズに合わせてモデルを調整できます
応答パラメータの自由な調整: 出力の長さやスタイル、創造性レベルを細かく制御できます
独自のプロンプトエンジニアリング: 組織のナレッジベースや用途に合わせた入力形式を設計できます
コスト管理の容易さ
定額投資: 初期投資後の追加コストが発生しにくく、利用量に関わらず費用が予測しやすいです
長期的なコスト削減: 高頻度利用のケースでは、ローカル運用の方が経済的になる場合があります
サブスクリプション不要: 継続的な支払いが不要で、予算管理が容易です
安定性と可用性
インターネット接続に依存しない: オフライン環境でも継続的に利用可能です
外部サービスの障害に影響されない: クラウドプロバイダーの問題に左右されません
レイテンシの改善: ローカル処理によりレスポンス時間を短縮できる場合があります
次の記事も参照:【ChatGPTの危険性】企業が使用を禁止する5つの理由と安全な活用法
ローカルLLMの限界とデメリット
しかし、ローカルでLLMを運用する際にはいくつかのデメリットも存在します。
ハードウェア要件の高さ
高性能なリソースが必要: 特に大きなモデルでは、十分なRAMとGPUが不可欠です
初期投資コスト: 適切なハードウェアの準備に相応の投資が必要です
電力消費: 高性能GPUの稼働は電力消費が大きいことがあります
モデル性能の制約
最先端モデルとの性能差: オープンソースモデルは商用モデルと比べて性能面での差がある場合があります
モデルサイズの制限: ハードウェア制約により、利用できるモデルサイズに制限があります
最適化の難しさ: パラメータ調整やモデル最適化に専門知識が必要です
運用・保守の負担
アップデート管理: モデルの更新やセキュリティパッチの適用は自己責任です
技術的障壁: 設定や運用には一定の技術知識が必要です
スケーラビリティの課題: 利用者や処理量の増加に対応するためのリソース拡張が必要になります
利用可能なモデルの制限
商用モデル利用不可: GPT-4やClaudeなどの最先端商用モデルは利用できません
特殊機能の制限: マルチモーダル機能(画像処理など)が限定される場合があります
フィールドテスト不足: 一部のオープンソースモデルは実戦での十分な検証が行われていない場合があります
LLMをローカルで動かすことは、プライバシー重視の環境や特定用途向けのカスタマイズが必要なケースで非常に有効です。しかし、その恩恵を最大限に活かすためには、上記の制約を理解し、適切な対応策を講じることが重要です。
いよいよ次から、これらの課題を踏まえた上で、Ollamaを使用してローカル環境にLLMを構築するための準備について解説していきます。
Ollamaでローカルにモデルを構築するための準備
ローカル環境でLLMを動かすための選択肢はいくつかありますが、その中でもOllamaは、セットアップの容易さと使いやすさで際立っています。
Ollama(オラマ)とは、パソコンやスマホなどのデバイス上で動作するAI(人工知能)を簡単に使えるようにするツールです。
普通、ChatGPTのようなAIを使うには、インターネットに接続してサーバー(クラウド)を通じて利用します。でも、Ollamaを使えば、AIを自分のパソコンの中だけで動かすことができるのが特徴です。
ここでは、Ollamaを使ってローカルマシンでLLMを動かすための事前準備について詳しく解説します。
必要なハードウェアの確認
LLMをスムーズに動かすには、適切なハードウェアが不可欠です。モデルのサイズや用途によって要件は異なりますが、一般的な目安は以下の通りです。
最低要件と推奨スペック
コンポーネント | 最低要件 | 推奨スペック |
|---|---|---|
CPU | 4コア (Intel i5 / Ryzen 5) | 8コア以上 (Intel i7 / Ryzen 7) |
RAM | 8GB | 16GB以上(多いほど良い) |
GPU(オプション) | なくても動作可能 | NVIDIA GPU(CUDA対応)で処理速度向上 |
ストレージ | 最低20GB以上の空き容量 | SSD推奨(モデルの読み込み速度向上) |
モデルサイズとハードウェア要件の関係
モデルサイズによって必要なリソースは大きく異なります:
小型モデル(1B〜7B): 標準的なノートPCでも動作可能
中型モデル(7B〜13B): 16GB以上のRAMと、可能であればGPUを推奨
大型モデル(30B〜70B): 32GB以上のRAMと専用GPUが必須
実際にOllamaでモデルを動かす際、システムメモリが不足している場合、「model requires more system memory (X GiB) than is available (Y GiB)」というエラーが表示されます。その場合は、より小さなモデルを選択するか、ハードウェアをアップグレードする必要があります。
パフォーマンス向上のポイント
ローカルLLMのパフォーマンスを向上させるいくつかのポイントがあります:
SSDストレージ: モデルの読み込み時間を大幅に短縮できます
適切な冷却: 長時間の使用ではCPU/GPUの発熱に注意が必要です
バックグラウンドプロセスの最小化: 他のリソース消費プロセスを閉じることでパフォーマンスが向上します
GPUを持っていなくても心配ありません。OllamaはCPUでもLLMを実行できますが、速度は遅くなる場合があります。
Dockerのインストール
Ollamaはコンテナ化された環境でLLMを実行するため、Dockerが必要です。まずはDockerをインストールしましょう。
Docker(ドッカー)は、アプリケーションを軽量な仮想環境(コンテナ)で動作させるためのツールです。
Windows用Dockerのインストール手順
Docker Desktop公式サイトからインストーラーをダウンロード
ダウンロードしたインストーラーを実行
指示に従ってインストールを完了
インストール完了後、Docker Desktopを起動
Mac用Dockerのインストール手順
Docker Desktop公式サイトからMac用インストーラーをダウンロード
ダウンロードした.dmgファイルを開き、Applicationsフォルダにドラッグ
Applicationsフォルダから「Docker」を起動
必要に応じてシステム許可を与える
Linux用Dockerのインストール手順
Ubuntuの場合:
sudo apt-get update
sudo apt-get install docker-ce docker-ce-cli containerd.io
他のディストリビューションについては公式ドキュメントを参照してください。
インストール確認
Dockerが正しくインストールされたか確認するには、ターミナルで以下のコマンドを実行します:
docker --version
以下のような出力が表示されれば成功です:
Docker version 24.0.5, build 1234567
Ollamaのインストール方法
Dockerがインストールできたら、次はOllamaをインストールします。
macOS/Linuxでのインストール
ターミナルを開いて以下のコマンドを実行します:
curl -fsSL <https://ollama.com/install.sh> | sh
Windows版のインストール
Windows版のOllamaは公式のMSI形式インストーラーが提供されています:
Ollama公式サイトからWindowsインストーラーをダウンロード
ダウンロードしたMSIファイルを実行
画面の指示に従ってインストールを完了
インストール確認
インストールが完了したら、以下のコマンドでOllamaのバージョンを確認できます:
ollama --version
以下のような出力が表示されれば成功です:
ollama version is 0.5.12
最適なモデル選びのポイント
Ollamaで使用できるモデルはたくさんありますが、自分のニーズと使用できるハードウェアに合ったモデルを選ぶことが重要です。
主要なモデルとその特徴
Ollama を初めて使用する場合は、リストが空か、llama3:latest モデルになっている可能性があります。Llama3:latest は、Model Meta llama 3 8B Instruct Q4_0 の別名です (Q4_0 はこのモデルの量子化タイプです。これについては、別のシリーズで後ほど説明します。)
利用可能なモデルは、Ollama のモデル ライブラリで参照できます。
以下は、Ollama で利用可能な最先端の大規模言語モデル (LLM) とその説明および最適な使用例をまとめた表です。
モデル名 | 特徴 | 推奨用途 |
|---|---|---|
Llama 3.3 70B | Metaの70Bパラメータモデル。Llama 3.1 405Bに匹敵する性能を持つ | 高性能な自然言語処理と推論が必要なアプリ |
DeepSeek-R1 | DeepSeekの推論モデル。OpenAI-o1に匹敵する性能 | 複雑なデータ分析と推論タスク |
Phi-4 14B | Microsoftの14Bパラメータモデル。言語処理と推論機能が高い | 言語分析と論理的推論の精度が求められるタスク |
Mistral 7B | Mistral AIの7Bパラメータモデル。コンパクトながら高性能 | リソースが限られた環境でも高性能な処理が必要な場合 |
Qwen2.5 72B | Alibabaの新シリーズ。最大128Kトークンのコンテキストと多言語サポート | 長文処理と多言語機能が必要なタスク |
Gemma 2B/7B/9B | Google DeepMindの軽量高性能モデル | パーソナルデバイスやモバイルアプリ向け |
Dolphin 3.0 Llama 3.1 8B | Llama 3.1 8Bをベースに調整された汎用モデル | コーディング、数学、エージェント機能が必要な場合 |
モデル選択の基準
モデルを選ぶ際は、以下の点を考慮すると良いでしょう:
ハードウェア要件: お使いのマシンのスペックに合ったサイズのモデルを選びましょう
用途: コード生成、文章作成、質問応答など、目的に合ったモデルを選びましょう
性能バランス: 速度と精度のバランスを考慮しましょう
特殊機能: 長いコンテキスト処理や多言語対応など、必要な特殊機能があるかを確認しましょう
量子化タイプについて
モデルによっては「Q4_0」などの表記があります。これは「量子化」と呼ばれる圧縮技術で、精度をやや犠牲にしてモデルサイズを小さくし、必要なリソースを減らす技術です。主な量子化タイプには:
Q4: 4ビット量子化。メモリ使用量が少なく速度も速いが、やや精度が落ちる
Q5: 5ビット量子化。Q4とQ8の中間的な性能
Q8: 8ビット量子化。精度は高いがメモリ使用量が多い
リソースに制約がある場合はQ4モデルを、精度を重視するならQ8モデルを選ぶと良いでしょう。
これらの準備が整えば、次のステップでは実際にモデルをダウンロードして動かす方法を解説します。Ollamaの素晴らしいところは、これらすべてが非常にシンプルなコマンドで実行できることです。
ステップバイステップ:Ollamaでのモデルセットアップと実行
準備が整ったところで、いよいよOllamaを使って実際にLLMをローカルで動かしていきましょう。この章では、モデルのダウンロードから実行、そして基本的な使い方までを順を追って解説します。
RabilooチームのGitHub リポジトリは https://github.com/rabiloo/llm-on-local で公開されています。このリポジトリをクローンし、付属の指示に従って進めるか、あるいはご自身のニーズに合わせてベストプラクティスを参考にカスタマイズすることができます。
モデルのダウンロードと管理方法
Ollamaでは、シンプルなコマンドでモデルのダウンロードや管理ができます。ここでは基本的な操作方法を紹介します。
1.利用可能なモデルの確認
まずは、すでにダウンロード済みのモデルを確認してみましょう。ターミナルで以下のコマンドを実行します:
ollama list
初めて使用する場合は、リストが空であるか、llama3:latestモデルのみが表示される可能性があります。llama3:latestは、Meta社のLlama 3 8B Instructモデル(Q4_0量子化版)のエイリアスです。
2.モデルのダウンロード
Ollamaライブラリから新しいモデルをダウンロードするには、以下のコマンドを使います:
ollama pull <モデル名>
例えば、DeepSeek-R1モデルをダウンロードする場合は:
ollama pull deepseek-r1
ダウンロードには、モデルのサイズとインターネット接続速度に応じて数分から数十分かかる場合があります。ダウンロードが完了すると、モデルはローカルストレージに保存され、使用できる状態になります。
以下は、初心者に特におすすめのモデルです:
Llama3:Meta社の最新モデルで、汎用性が高く使いやすい
Mistral 7B:比較的小さなサイズながら優れたパフォーマンスを発揮
Gemma 2B:非常に軽量で、リソースが限られた環境でも動作しやすい
3.モデルの削除
ストレージを節約するために、使わなくなったモデルを削除することもできます:
ollama rm <モデル名>
例えば:
ollama rm deepseek-r1
このコマンドを実行すると、指定したモデルがローカルストレージから完全に削除されます。必要になった場合は再度ダウンロードする必要があります。
モデルをローカルで起動する手順
モデルをダウンロードしたら、次はそれを実行してみましょう。
基本的な起動方法
モデルを実行するには、以下のコマンドを使います:
ollama run <モデル名>
例えば、Llama3モデルを起動する場合:
ollama run llama3
このコマンドを実行すると、Ollamaは以下の処理を行います:
モデルをメモリにロード(ハードウェアに応じて数秒から数分かかります)
ローカルAPIサーバーを起動(デフォルトでは
http://localhost:11434/v1でアクセス可能)モデルの準備ができると、対話形式でプロンプトの入力を待つ状態になる
バックグラウンドでの実行
APIリクエストを処理するためだけにモデルを実行したい場合は、バックグラウンドで起動することもできます:
ollama serve &>/dev/null &
このコマンドは、Ollamaをバックグラウンドプロセスとして実行し、ターミナル出力を無視します。これにより、他のアプリケーションからAPIを通じてモデルにアクセスできるようになります。
モデル実行状態の確認
モデルが正常に実行されているかを確認するには、新しいターミナルウィンドウを開いて以下のコマンドを実行します:
curl <http://localhost:11434/v1/models>
正常に動作している場合、利用可能なモデルのリストがJSON形式で返されます:
{
  "object": "list",
  "data": [
    {
      "id": "deepseek-r1:latest",
      "object": "model",
      "created": 1700000000,
      "owned_by": "library"
    },
    {
      "id": "llama3:latest",
      "object": "model",
      "created": 1700000000,
      "owned_by": "library"
    }
  ]
}
この出力は、モデルが正常にロードされ、リクエストを処理する準備ができていることを確認するものです。
APIリクエストの送信方法
Ollamaを実行したら、APIを使ってモデルと対話することができます。以下では、基本的なAPIリクエストの方法を紹介します。
cURLを使った基本的なリクエスト
ターミナルからcURLを使って簡単なリクエストを送信できます:
curl -X POST <http://localhost:11434/v1/chat/completions> \\
     -H "Content-Type: application/json" \\
     -d '{
          "model": "llama3",
          "messages": [{"role": "user", "content": "再帰処理を簡単に説明してください。"}],
          "max_tokens": 100
        }'
システムメモリが十分でない場合は、以下のようなエラーが返されます:
{
  "error": {
    "message": "model requires more system memory (X GiB) than is available (Y GiB)",
    "type": "api_error",
    "param": null,
    "code": null
  }
}
正常に処理された場合は、以下のような応答が返されます:
{
  "id": "chatcmpl-xyz",
  "object": "chat.completion",
  "created": 1700000000,
  "model": "llama3",
  "system_fingerprint": "fp_ollama",
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "再帰処理とは、問題を同じ問題のより小さなバージョンに分解することで解決する方法です。関数が簡単な解決策に到達するまで、自分自身を繰り返し呼び出します。例えば、階段を下りる際に「この問題を解決するために、一段下りて、また同じことをする」という考え方に似ています。"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": {
    "prompt_tokens": 17,
    "completion_tokens": 65,
    "total_tokens": 82
  }
}
Pythonを使ったリクエスト
Pythonではrequestsライブラリを使って簡単にAPIリクエストを送信できます:
import requests

url = "<http://localhost:11434/v1/chat/completions>"
headers = {"Content-Type": "application/json"}
data = {
    "model": "llama3",
    "messages": [{"role": "user", "content": "再帰処理を簡単に説明してください。"}],
    "max_tokens": 100
}

response = requests.post(url, json=data, headers=headers)
print(response.json())
このスクリプトは、モデルにチャットリクエストを送信し、応答をJSON形式で表示します。
会話の継続
複数のメッセージを含む会話を継続するには、messages配列に過去のやり取りを含めます:
data = {
    "model": "llama3",
    "messages": [
        {"role": "user", "content": "再帰処理を簡単に説明してください。"},
        {"role": "assistant", "content": "再帰処理とは、問題を同じ問題のより小さなバージョンに分解することで解決する方法です..."},
        {"role": "user", "content": "具体的なプログラミング例を教えてください。"}
    ],
    "max_tokens": 200
}
このように、過去の会話コンテキストを保持することで、より自然な対話が可能になります。
応答パラメータの調整テクニック
APIリクエストでは、さまざまなパラメータを調整することで、モデルの応答をカスタマイズできます。
主要なパラメータとその効果
パラメータ | 説明 | 推奨値の例 |
|---|---|---|
max_tokens | 応答の最大長を制限 | 100(短め)/ 500(長め) |
temperature | ランダム性の制御(高い=創造的、低い=決定論的) | 0.7(バランス)/ 0.1(焦点を絞る) |
top_p | トークン選択を狭めて多様性を制限 | 0.9(高多様性)/ 0.5(低多様性) |
frequency_penalty | 繰り返しを減らす | 0.2(軽度)/ 1.0(強い) |
presence_penalty | 新しいトピックの導入を促す | 0.0(中立)/ 0.8(より多様) |
創造的な応答の生成
より創造的な応答を生成するには、temperatureを高く設定します:
curl -X POST <http://localhost:11434/v1/chat/completions> \\
     -H "Content-Type: application/json" \\
     -d '{
          "model": "llama3",
          "messages": [{"role": "user", "content": "SFストーリーのアイデアを教えてください!"}],
          "temperature": 1.0,
          "max_tokens": 200
        }'
構造化された予測可能な応答
より構造化された予測可能な応答を得るには、temperatureを低く設定します:
curl -X POST <http://localhost:11434/v1/chat/completions> \\
     -H "Content-Type: application/json" \\
     -d '{
          "model": "llama3",
          "messages": [{"role": "user", "content": "プログラミング初心者向けにPythonの基本を説明してください"}],
          "temperature": 0.2,
          "max_tokens": 300
        }'
システムプロンプトの活用
モデルの応答スタイルや役割を設定するには、システムプロンプトを使用できます:
curl -X POST <http://localhost:11434/v1/chat/completions> \\
     -H "Content-Type: application/json" \\
     -d '{
          "model": "llama3",
          "messages": [
            {"role": "system", "content": "あなたは簡潔かつ具体的な例を使って説明するプログラミング講師です。中学生でも理解できる言葉で説明してください。"},
            {"role": "user", "content": "オブジェクト指向プログラミングとは何ですか?"}
          ],
          "temperature": 0.5,
          "max_tokens": 250
        }'
Ollamaの停止方法
Ollamaの使用が終わったら、以下のコマンドでプロセスを停止できます:
pkill ollama
あるいは、プロセスIDを見つけて停止する方法もあります:
ps aux | grep ollama
kill -9 <プロセスID>
これで、基本的なOllamaの使い方をマスターできました。次章では、これらの知識を活用して、実際のアプリケーションにローカルLLMを統合する方法を解説します。
ローカルLLMの実践的な活用方法
ローカルでLLMを動かせるようになったら、次はそれを実際のアプリケーションに組み込んでみましょう。この章では、Ollamaを使ったローカルLLMの実践的な活用方法を紹介します。Webアプリケーションの開発から既存システムとの連携、パフォーマンス最適化まで、幅広く解説していきます。
Pythonでチャットボット開発
Pythonを使えば、ローカルLLMを活用した独自のチャットボットアプリケーションを簡単に作成できます。以下に、FastAPIを使用した基本的なチャットボットの例を示します。
FastAPIを使ったシンプルなチャットボットAPI
FastAPIは高速で使いやすいPythonのWebフレームワークです。以下のコードで、ローカルLLMにアクセスするAPIエンドポイントを作成できます:
import requests
from fastapi import FastAPI, Form

app = FastAPI()
OLLAMA_URL = "<http://localhost:11434/v1/chat/completions>"

@app.post("/chatbot")
async def chatbot(
    model_alias: str = Form(default="llama3"),
    question: str = Form(default=""),
):
    payload = {
        "model": model_alias,
        "messages": [{"role": "user", "content": question}],
        "temperature": 0.2,
    }
    response = requests.post(OLLAMA_URL, json=payload).json()

    if response.get("choices") is None:
        return response["error"].get("message", "Error: No response from Ollama.")

    return response["choices"][0]["message"].get("content", "Error: No response from Ollama.")

# uvicorn script_name:app --reload で実行
このコードをchatbot_api.pyとして保存し、以下のコマンドで実行できます:
pip install fastapi uvicorn requests
uvicorn chatbot_api:app --reload
サーバーが起動したら、http://localhost:8000/docsにアクセスして、APIをテストできます。
チャットボットの機能拡張
基本的なチャットボットをさらに発展させるためのアイデアをいくつか紹介します:
1.会話履歴の管理:会話コンテキストを保持して継続的な対話を可能にします
from fastapi import FastAPI, Form, Depends, HTTPException
from pydantic import BaseModel
import requests
import uuid
from typing import List, Dict, Optional

app = FastAPI()
OLLAMA_URL = "<http://localhost:11434/v1/chat/completions>"

# 会話履歴を保存するディクショナリ
conversations = {}

class Message(BaseModel):
    role: str
    content: str

class Conversation(BaseModel):
    conversation_id: str
    messages: List[Message]

@app.post("/start_conversation")
async def start_conversation():
    conversation_id = str(uuid.uuid4())
    conversations[conversation_id] = []
    return {"conversation_id": conversation_id}

@app.post("/chat")
async def chat(
    conversation_id: str = Form(...),
    model_alias: str = Form(default="llama3"),
    question: str = Form(...),
):
    if conversation_id not in conversations:
        raise HTTPException(status_code=404, detail="Conversation not found")

    # 会話履歴を取得
    history = conversations[conversation_id]

    # ユーザーメッセージを追加
    user_message = {"role": "user", "content": question}
    history.append(user_message)

    # APIリクエスト
    payload = {
        "model": model_alias,
        "messages": history,
        "temperature": 0.2,
    }
    response = requests.post(OLLAMA_URL, json=payload).json()

    if response.get("choices") is None:
        return {"error": response["error"].get("message", "Error: No response from Ollama.")}

    # アシスタントの応答を会話履歴に追加
    assistant_message = response["choices"][0]["message"]
    history.append(assistant_message)
    conversations[conversation_id] = history

    return assistant_message
2.システムプロンプトのカスタマイズ:特定のペルソナや専門知識を持つチャットボットを作成
@app.post("/specialized_chat")
async def specialized_chat(
    conversation_id: str = Form(...),
    model_alias: str = Form(default="llama3"),
    question: str = Form(...),
    persona: str = Form(default="general"),
):
    # 各ペルソナに応じたシステムプロンプト
    personas = {
        "general": "あなたは親切で役立つアシスタントです。",
        "teacher": "あなたは教育者として、わかりやすく丁寧に説明することを心がけます。例を多用し、中学生でも理解できる言葉で説明してください。",
        "programmer": "あなたはプログラミングの専門家です。コードの例を示し、ベストプラクティスを提案してください。",
        "business": "あなたはビジネスコンサルタントです。戦略的な視点からアドバイスを提供し、具体的なビジネスシナリオを想定して回答してください。"
    }

    system_prompt = personas.get(persona, personas["general"])

    # 以下、会話処理のコード...
3.エラーハンドリングの改善:タイムアウトやモデルの不具合に対処
import time
import requests
from fastapi import HTTPException

def retry_request(payload, max_retries=3, timeout=30):
    for attempt in range(max_retries):
        try:
            response = requests.post(OLLAMA_URL, json=payload, timeout=timeout)
            return response.json()
        except requests.exceptions.Timeout:
            if attempt == max_retries - 1:
                raise HTTPException(status_code=504, detail="Request to Ollama timed out")
            time.sleep(1)
        except requests.exceptions.RequestException as e:
            raise HTTPException(status_code=500, detail=f"Error connecting to Ollama: {str(e)}")
ウェブインターフェースの構築
チャットボットAPIをより使いやすくするために、ウェブインターフェースを追加しましょう。Gradioを使えば、数行のコードでインタラクティブなUIを作成できます。
Gradioを使ったチャットUI
import gradio as gr
import requests

URL = "<http://localhost:11434/v1/chat/completions>"

def chat_function(message, history):
    payload = {
        "model": "llama3",
        "messages": [{"role": "user", "content": message}],
    }
    response = requests.post(URL, json=payload)
    reply = response.json()["choices"][0]["message"].get("content", "Error: No response from Ollama.")
    return "", history + [(message, reply)]

with gr.Blocks() as demo:
    with gr.Tab("チャットボット"):
        gr.Markdown(value="## ローカルAIチャットボット")
        with gr.Row():
            with gr.Column():
                msg = gr.Textbox(placeholder="メッセージを入力してください...")
                btn = gr.Button("送信")
            chatbot = gr.Chatbot(height=800)
        btn.click(chat_function, inputs=[msg, chatbot], outputs=[msg, chatbot])

demo.launch(server_name="0.0.0.0", server_port=7860)
このコードをchatbot_ui.pyとして保存し、以下のコマンドで実行します:
pip install gradio requests
python chatbot_ui.py
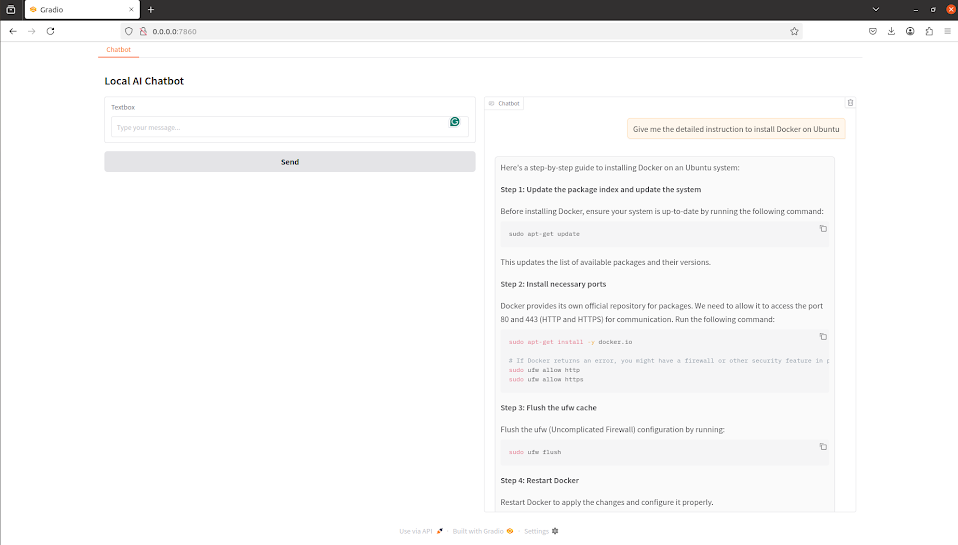
ブラウザでhttp://localhost:7860にアクセスすると、以下のようなシンプルなチャットインターフェースが表示されます。
HTMLとJavaScriptを使ったカスタムUI
より本格的なUIを作成したい場合は、HTMLとJavaScriptを使ってカスタムUIを作成できます。以下は、FastAPIとVanilla JavaScriptを使った例です:
# fastapi_chat_app.py
from fastapi import FastAPI, Request
from fastapi.responses import HTMLResponse
from fastapi.staticfiles import StaticFiles
from fastapi.templating import Jinja2Templates
import os

app = FastAPI()

# 静的ファイル(CSS、JavaScript)の提供
app.mount("/static", StaticFiles(directory="static"), name="static")
templates = Jinja2Templates(directory="templates")

@app.get("/", response_class=HTMLResponse)
async def read_root(request: Request):
    return templates.TemplateResponse("index.html", {"request": request})

# APIエンドポイント(前述のchatbotエンドポイント)も含めます
そして、HTML/JavaScriptファイルを作成します:
<!-- templates/index.html -->
<!DOCTYPE html>
<html lang="ja">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>ローカルLLMチャットボット</title>
    <link rel="stylesheet" href="/static/style.css">
</head>
<body>
    <div class="chat-container">
        <h1>ローカルLLMチャットボット</h1>
        <div class="chat-box" id="chatBox"></div>
        <div class="input-area">
            <select id="modelSelect">
                <option value="llama3">Llama 3</option>
                <option value="mistral">Mistral</option>
                <option value="gemma">Gemma</option>
            </select>
            <input type="text" id="userInput" placeholder="メッセージを入力..." />
            <button id="sendBtn">送信</button>
        </div>
    </div>
    <script src="/static/script.js"></script>
</body>
</html>
// static/script.js
document.addEventListener('DOMContentLoaded', () => {
    const chatBox = document.getElementById('chatBox');
    const userInput = document.getElementById('userInput');
    const sendBtn = document.getElementById('sendBtn');
    const modelSelect = document.getElementById('modelSelect');

    sendBtn.addEventListener('click', sendMessage);
    userInput.addEventListener('keypress', (e) => {
        if (e.key === 'Enter') {
            sendMessage();
        }
    });

    function sendMessage() {
        const message = userInput.value.trim();
        if (message === '') return;

        // ユーザーメッセージを表示
        addMessage('user', message);
        userInput.value = '';

        // ローディング表示
        const loadingElem = document.createElement('div');
        loadingElem.className = 'message loading';
        loadingElem.textContent = '...';
        chatBox.appendChild(loadingElem);
        chatBox.scrollTop = chatBox.scrollHeight;

        // APIリクエスト
        fetch('/chatbot', {
            method: 'POST',
            headers: {
                'Content-Type': 'application/x-www-form-urlencoded',
            },
            body: new URLSearchParams({
                model_alias: modelSelect.value,
                question: message
            })
        })
        .then(response => response.text())
        .then(data => {
            // ローディング要素を削除
            chatBox.removeChild(loadingElem);
            // AIの応答を表示
            addMessage('assistant', data);
        })
        .catch(error => {
            console.error('Error:', error);
            chatBox.removeChild(loadingElem);
            addMessage('system', 'エラーが発生しました。もう一度お試しください。');
        });
    }

    function addMessage(role, content) {
        const messageElem = document.createElement('div');
        messageElem.className = `message ${role}`;

        // 改行をHTMLで反映
        const formattedContent = content.replace(/\\n/g, '<br>');
        messageElem.innerHTML = formattedContent;

        chatBox.appendChild(messageElem);
        chatBox.scrollTop = chatBox.scrollHeight;
    }
});
/* static/style.css */
body {
    font-family: Arial, sans-serif;
    margin: 0;
    padding: 0;
    display: flex;
    justify-content: center;
    background-color: #f5f5f5;
}

.chat-container {
    width: 80%;
    max-width: 800px;
    margin: 20px;
    border-radius: 10px;
    box-shadow: 0 0 10px rgba(0,0,0,0.1);
    background-color: white;
    overflow: hidden;
}

h1 {
    text-align: center;
    padding: 15px;
    margin: 0;
    background-color: #4285f4;
    color: white;
}

.chat-box {
    height: 500px;
    padding: 15px;
    overflow-y: auto;
}

.message {
    padding: 10px 15px;
    margin: 5px 0;
    border-radius: 10px;
    max-width: 80%;
}

.user {
    background-color: #e3f2fd;
    margin-left: auto;
    text-align: right;
}

.assistant {
    background-color: #f0f0f0;
    margin-right: auto;
}

.system {
    background-color: #ffebee;
    margin: 5px auto;
    text-align: center;
}

.loading {
    background-color: #f0f0f0;
    margin-right: auto;
    animation: pulse 1.5s infinite;
}

@keyframes pulse {
    0% { opacity: 0.5; }
    50% { opacity: 1; }
    100% { opacity: 0.5; }
}

.input-area {
    display: flex;
    padding: 15px;
    border-top: 1px solid #e0e0e0;
}

input {
    flex: 1;
    padding: 10px;
    border: 1px solid #ddd;
    border-radius: 5px;
    margin-right: 10px;
}

select {
    padding: 10px;
    border: 1px solid #ddd;
    border-radius: 5px;
    margin-right: 10px;
    background-color: white;
}

button {
    padding: 10px 15px;
    background-color: #4285f4;
    color: white;
    border: none;
    border-radius: 5px;
    cursor: pointer;
}

button:hover {
    background-color: #3367d6;
}
このようにして、Webインターフェースを構築することで、ローカルLLMをより使いやすく、便利なツールにすることができます。
既存のアプリケーションとの連携
ローカルLLMを既存のアプリケーションと統合することで、その機能を大幅に拡張できます。以下に、いくつかの一般的な統合シナリオを紹介します。
コンテンツ管理システム(CMS)との連携
WordPressなどのCMSにローカルLLMを統合して、コンテンツ生成や編集支援を行うことができます。以下は、WordPressプラグインのコンセプトです:
<?php
/**
 * Plugin Name: Local LLM Assistant
 * Description: WordPressにローカルLLMを統合してコンテンツ作成を支援
 * Version: 1.0
 */

// LLMへのAPIリクエスト関数
function llm_api_request($prompt) {
    $url = '<http://localhost:11434/v1/chat/completions>';
    $args = array(
        'body' => json_encode(array(
            'model' => 'llama3',
            'messages' => array(
                array('role' => 'user', 'content' => $prompt)
            )
        )),
        'headers' => array('Content-Type' => 'application/json'),
        'timeout' => 60
    );

    $response = wp_remote_post($url, $args);

    if (is_wp_error($response)) {
        return 'Error: ' . $response->get_error_message();
    }

    $body = wp_remote_retrieve_body($response);
    $data = json_decode($body, true);

    return $data['choices'][0]['message']['content'];
}

// 管理画面にボタンを追加
function add_llm_buttons() {
    echo '<div class="llm-assistant-tools">';
    echo '<button type="button" class="button button-secondary" id="improve-content">文章改善</button>';
    echo '<button type="button" class="button button-secondary" id="summarize-content">要約作成</button>';
    echo '<button type="button" class="button button-secondary" id="generate-title">タイトル生成</button>';
    echo '</div>';

    // JavaScriptを追加
    wp_enqueue_script('llm-assistant', plugin_dir_url(__FILE__) . 'js/llm-assistant.js', array('jquery'), '1.0', true);
    wp_localize_script('llm-assistant', 'llm_assistant', array(
        'ajax_url' => admin_url('admin-ajax.php'),
        'nonce' => wp_create_nonce('llm_assistant_nonce')
    ));
}
add_action('edit_form_after_title', 'add_llm_buttons');

// AJAXリクエストを処理
function handle_llm_request() {
    check_ajax_referer('llm_assistant_nonce', 'nonce');

    $action = sanitize_text_field($_POST['llm_action']);
    $content = sanitize_textarea_field($_POST['content']);

    switch ($action) {
        case 'improve':
            $prompt = "以下の文章を改善してください。文法や表現を自然にし、読みやすくしてください:\\n\\n" . $content;
            break;
        case 'summarize':
            $prompt = "以下の文章を3〜5行で要約してください:\\n\\n" . $content;
            break;
        case 'title':
            $prompt = "以下の文章に適したSEOフレンドリーなタイトルを5つ提案してください:\\n\\n" . $content;
            break;
        default:
            wp_send_json_error('無効なアクション');
            return;
    }

    $result = llm_api_request($prompt);
    wp_send_json_success($result);
}
add_action('wp_ajax_llm_request', 'handle_llm_request');
?>
社内知識ベースとの連携
社内ドキュメントやナレッジベースとローカルLLMを統合することで、カスタマイズされた質問応答システムを構築できます:
from fastapi import FastAPI, Form, File, UploadFile
import requests
import os
from docx import Document
from PyPDF2 import PdfReader
import pandas as pd

app = FastAPI()
OLLAMA_URL = "<http://localhost:11434/v1/chat/completions>"

# ドキュメントの保存場所
DOCS_DIR = "knowledge_base"
os.makedirs(DOCS_DIR, exist_ok=True)

# システムプロンプト
SYSTEM_PROMPT = """あなたは社内のナレッジアシスタントです。以下のドキュメント情報をもとに質問に回答してください。
情報が不足している場合は、正直にわからないと伝えてください。
"""

# ドキュメントをアップロードするエンドポイント
@app.post("/upload_document")
async def upload_document(file: UploadFile = File(...)):
    file_path = os.path.join(DOCS_DIR, file.filename)

    with open(file_path, "wb") as f:
        f.write(await file.read())

    # ファイル形式に応じたテキスト抽出
    if file.filename.endswith(".docx"):
        doc = Document(file_path)
        content = "\\n".join([para.text for para in doc.paragraphs])
    elif file.filename.endswith(".pdf"):
        reader = PdfReader(file_path)
        content = ""
        for page in reader.pages:
            content += page.extract_text() + "\\n"
    elif file.filename.endswith(".csv"):
        df = pd.read_csv(file_path)
        content = df.to_string()
    elif file.filename.endswith(".txt"):
        with open(file_path, "r", encoding="utf-8") as f:
            content = f.read()
    else:
        return {"message": "サポートされていないファイル形式です"}

    # ナレッジベースにコンテンツを保存
    with open(os.path.join(DOCS_DIR, f"{file.filename}.txt"), "w", encoding="utf-8") as f:
        f.write(content)

    return {"message": f"{file.filename}がナレッジベースに追加されました"}

# 質問応答エンドポイント
@app.post("/ask")
async def ask_question(question: str = Form(...)):
    # ナレッジベースからコンテンツを取得
    knowledge = ""
    for filename in os.listdir(DOCS_DIR):
        if filename.endswith(".txt"):
            with open(os.path.join(DOCS_DIR, filename), "r", encoding="utf-8") as f:
                knowledge += f.read() + "\\n\\n"

    if not knowledge:
        return {"answer": "ナレッジベースにドキュメントがありません。まずはドキュメントをアップロードしてください。"}

    # コンテキストサイズの制限(Ollamaのトークン制限に応じて調整)
    if len(knowledge) > 10000:
        knowledge = knowledge[:10000] + "..."

    # LLMに質問を送信
    payload = {
        "model": "llama3",
        "messages": [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": f"ナレッジベース情報:\\n{knowledge}\\n\\n質問: {question}"}
        ],
        "temperature": 0.2,
    }

    response = requests.post(OLLAMA_URL, json=payload).json()

    if response.get("choices") is None:
        return {"answer": "エラーが発生しました。もう一度お試しください。"}

    return {"answer": response["choices"][0]["message"].get("content", "応答を取得できませんでした")}
開発環境との統合
VScodeなどのIDEにローカルLLMを統合して、コーディング支援を行うことができます。以下は、簡単なVScode拡張機能のコンセプトです:
// extension.js
const vscode = require('vscode');
const axios = require('axios');

function activate(context) {
    console.log('Local LLM Coding Assistant is active!');

    // コード補完コマンド
    let completeCodeCmd = vscode.commands.registerCommand('localLlm.completeCode', async function () {
        const editor = vscode.window.activeTextEditor;
        if (!editor) {
            vscode.window.showErrorMessage('エディタが開かれていません');
            return;
        }

        const selection = editor.selection;
        const text = editor.document.getText(selection);

        if (!text) {
            vscode.window.showInformationMessage('コード補完するテキストを選択してください');
            return;
        }

        vscode.window.withProgress({
            location: vscode.ProgressLocation.Notification,
            title: "コード生成中...",
            cancellable: false
        }, async (progress) => {
            try {
                const result = await requestLlm(
                    `以下のコードを補完してください。完成形のコードのみを返してください。:\\n\\n${text}`
                );

                editor.edit(editBuilder => {
                    editBuilder.replace(selection, result);
                });

                vscode.window.showInformationMessage('コードが補完されました');
            } catch (error) {
                vscode.window.showErrorMessage(`エラー: ${error.message}`);
            }
        });
    });

    // コード説明コマンド
    let explainCodeCmd = vscode.commands.registerCommand('localLlm.explainCode', async function () {
        const editor = vscode.window.activeTextEditor;
        if (!editor) return;

        const selection = editor.selection;
        const text = editor.document.getText(selection);

        if (!text) {
            vscode.window.showInformationMessage('説明するコードを選択してください');
            return;
        }

        try {
            const result = await requestLlm(
                `以下のコードを日本語で詳細に説明してください。何をしているのか、どのように動作するのかを解説してください:\\n\\n${text}`
            );

            // 新しいエディタでコード説明を表示
            const doc = await vscode.workspace.openTextDocument({
                content: result,
                language: 'markdown'
            });

            await vscode.window.showTextDocument(doc, { preview: false });
        } catch (error) {
            vscode.window.showErrorMessage(`エラー: ${error.message}`);
        }
    });

    context.subscriptions.push(completeCodeCmd, explainCodeCmd);
}

async function requestLlm(prompt) {
    try {
        const response = await axios.post('<http://localhost:11434/v1/chat/completions>', {
            model: 'codellama',
            messages: [{ role: 'user', content: prompt }],
            temperature: 0.2
        });

        return response.data.choices[0].message.content;
    } catch (error) {
        console.error('LLM API Error:', error);
        throw new Error('ローカルLLM APIへの接続エラー');
    }
}

function deactivate() {}

module.exports = {
    activate,
    deactivate
};
パフォーマンス最適化のコツ
ローカルLLMのパフォーマンスを最大化するためのテクニックをいくつか紹介します。
GPUの活用
NVIDIA GPUを持っている場合は、CUDA加速を有効にすることで処理速度を大幅に向上できます:
export OLLAMA_USE_CUDA=1
GPUが正しく検出されているか確認するには:
nvidia-smi
モデルロード時間の短縮
モデルの起動に時間がかかる場合は、以下の対策を試してみてください:
小さなモデルを使用する:
大型モデル(30B以上)よりも小型モデル(7B〜13B)を使用
量子化レベルの高いモデル(Q4)を選択
スレッド数の最適化:
OLLAMA_NUM_THREADS=4 ollama run llama3メモリマッピングの活用:
OLLAMA_MMAP=1 ollama run llama3
応答速度の向上
LLMの応答速度を向上させるテクニックをいくつか紹介します:
パラメータの最適化:
低いtemperature値を使用する(例:0.1〜0.3)
top_pを低く設定する(例:0.5〜0.7)
プロンプト最適化:
簡潔で明確なプロンプトを使用する
システムプロンプトで「簡潔に回答してください」と指示する
システムリソースの最適化:
バックグラウンドアプリを閉じる
不要なサービスを停止する
ハードウェアの温度管理を確認する(熱暴走すると性能低下する)
キャッシュの活用: よく使うプロンプトや回答をキャッシュすることで、繰り返しのリクエストを高速化します:
import functools
import time

# インメモリキャッシュ(24時間有効)
@functools.lru_cache(maxsize=100)
def cached_llm_request(prompt, model="llama3", temp=0.2, max_tokens=500):
    # キャッシュキーには現在の日付を含める(日ごとに更新)
    cache_date = time.strftime("%Y-%m-%d")
    # 実際のAPIリクエスト処理...
    return response
これらの最適化テクニックを適用することで、ローカルLLMの性能を大幅に向上させることができます。最後に、Ollamaの活用シーンと、いつOllamaを選ぶべきかについて次のパートで詳しく解説します。
Ollamaの活用シーンと選ぶべき状況
Ollamaはローカル環境でLLMを実行するための優れたツールですが、すべての状況に最適というわけではありません。この章では、Ollamaが特に効果的な活用シーンと、他の選択肢を検討すべき状況について詳しく解説します。
Ollamaを選ぶべき場面
以下のような目的や条件がある場合は、Ollamaが最適な選択肢となるでしょう。
プライバシーとセキュリティを最優先する場合
機密性の高い情報や個人情報を扱う場合、データが外部に送信されないローカルLLMは大きな安心感をもたらします。例えば、以下のような状況で有効です:
医療情報や患者データの分析・要約
企業の機密情報を含むドキュメント処理
個人情報保護法やGDPRなどの規制に厳密に従う必要がある場合
内部監査資料や財務データの処理
あるIT企業では、新製品開発に関する機密文書の分析にOllamaを活用し、情報漏洩のリスクを最小限に抑えながらAI支援を受けることに成功しています。
インターネット接続が不安定または不要な環境
インターネット接続が不安定な地域や、セキュリティ上の理由でインターネットから隔離された環境(エアギャップ環境)では、ローカルLLMが唯一の選択肢となることがあります:
災害地域や通信インフラの整っていない地域でのAI活用
高セキュリティ施設や軍事関連の応用
船舶や航空機などのオフライン環境
建設現場や鉱山など、ネットワークが不安定な作業現場
コスト効率を重視する長期的な利用
頻繁にLLMを利用する場合、従量課金制のクラウドAPIよりもローカル環境での実行が経済的になることがあります:
大量のテキスト処理や分析を継続的に行う場合
開発チームやサポートチームなど、常時AIアシスタントを必要とする部門
スタートアップや個人開発者などの予算が限られている場合
ある中小企業では、カスタマーサポート向けの回答生成システムをOllamaで構築し、年間のAPI利用料を大幅に削減できました。初期投資としてGPUサーバーを用意した後は、追加コストなしで安定して運用できています。
カスタマイズと実験を重視する場合
AI技術の可能性を探求し、特定の用途に最適化したい場合、Ollamaは優れた実験プラットフォームになります:
AIの研究開発
特定の業界や専門分野向けのカスタマイズ
教育目的での利用
小規模なプロトタイピングや概念実証
複数の教育機関では、学生にAI技術の理解を深めてもらうためのプラットフォームとしてOllamaを採用しています。学生は安全な環境でモデルの動作を学び、さまざまなプロンプトエンジニアリング技術を試すことができます。
他のLLM実行環境との比較
Ollamaは優れたツールですが、他にも選択肢があります。ユースケースに応じて最適なツールを選びましょう。
llama.cpp との比較
llama.cppはCPUでの実行に最適化された軽量のフレームワークです:
優位点: より徹底した最適化により低スペックマシンでも動作、より細かい設定が可能
弱点: セットアップの難易度が高く、APIインターフェースの実装が必要
小型デバイスやリソースの厳しく制限された環境では、llama.cppがより適しています。一方、使いやすさを重視するなら、Ollamaが優れています。
vLLM との比較
vLLMは高性能なサーバー環境向けのツールで、複数のリクエストを効率的に処理できます:
優位点: 高いスループット、複数ユーザーからの同時リクエスト処理に強い
弱点: セットアップが複雑、より多くのコンピュータリソースが必要
大規模なデプロイメントや複数のユーザーが同時アクセスする環境では、vLLMを検討する価値があります。
▶︎vLLMを使ってコストゼロで実現するローカルLLMホスティング実装ガイド
クラウドサービス(OpenAI API、Azure OpenAI)との比較
クラウドベースのLLMサービスは、管理の手間が少なく、常に最新のモデルにアクセスできるメリットがあります:
優位点: 最先端モデルへのアクセス、スケーラビリティ、管理の容易さ
弱点: 費用がかさむ可能性、プライバシーの懸念、インターネット接続が必須
新しい製品やサービスを迅速に市場に投入したい場合や、最高性能のモデルが必要な場合は、クラウドサービスが適しています。
実際の導入事例
Ollamaの実際の導入事例を見てみましょう。これらの事例は、ローカルLLMがどのように実用的な価値を生み出すかを示しています。
中小製造業での技術文書管理
ある製造業企業では、40年以上にわたる技術文書や設計図面の管理にOllamaを活用しています。これらの文書には企業の知的財産が含まれており、外部サービスに送信することはできませんでした。
Ollamaを使ったローカルLLMシステムにより、技術者はこれらの文書から素早く情報を検索・抽出できるようになりました。特に新入社員の教育や知識伝承に役立ち、ベテラン社員の退職による知識損失のリスクを軽減しています。
法律事務所での機密文書分析
ある法律事務所では、依頼者の機密情報を含む大量の法律文書を処理するためにOllamaを導入しました。契約書の分析、法的リスクの評価、判例の要約などにローカルLLMを活用し、弁護士の業務効率を大幅に向上させています。
データが事務所内のサーバーから外部に出ることはなく、依頼者のプライバシーとデータセキュリティを確保しつつ、AI技術のメリットを享受できています。
教育機関でのプログラミング学習支援
ある工科大学では、プログラミング教育の支援ツールとしてOllamaを導入しました。学生は自分のコードについて質問したり、デバッグのヒントを得たりすることができます。
学生のコードが外部に送信されないため、著作権やプライバシーの問題を気にせず利用できる点が評価されています。また、大学独自のプログラミング基準や教育方針に合わせたカスタマイズも行われています。
今後の展望と発展性
ローカルLLM技術は急速に進化しており、Ollamaもその一部です。今後予想される展開と、それに備える方法を見ていきましょう。
モデルの進化と軽量化
LLMの研究は日進月歩で進んでおり、より小さなモデルでも高い性能を発揮するモデルが次々と登場しています:
7B以下の小型モデルでも複雑なタスクをこなせるように
量子化技術の進化によるメモリ使用量の削減
より効率的なアーキテクチャによる推論速度の向上
今後はさらに普及価格帯のノートPCでも快適に動作するモデルが増えていくでしょう。
マルチモーダル対応の拡大
テキストだけでなく、画像や音声も扱えるマルチモーダルモデルがローカル環境でも実行可能になっていくと予想されます:
画像認識・分析能力の追加
音声入出力のサポート
ビデオ解析機能の統合
これにより、ローカルLLMの応用範囲が大幅に広がるでしょう。
エコシステムの成熟
Ollamaを中心としたエコシステムも成熟しつつあります:
サードパーティ製のGUIとの統合
豊富なプラグインやエクステンション
既存のソフトウェアとの連携強化
コミュニティによるカスタムモデルの充実
その中でRabilooも、ローカルLLMを活用したビジネスソリューションの提供に力を入れています。特に日本国内での活用事例を蓄積し、日本語環境での最適化ノウハウを提供していきます。
企業ユースの拡大
セキュリティとプライバシーへの懸念から、多くの企業がローカルLLMソリューションに注目するようになっています:
オンプレミスAIシステムの構築
既存のITインフラとの統合
業界特化型のカスタムモデル
ハイブリッドアプローチ(一部機能はクラウド、機密データ処理はローカル)
特に規制の厳しい業界や、機密情報を扱う企業での採用が進むでしょう。
Ollamaは、こうした発展の中心にあるツールの一つとして、今後もローカルLLM環境の標準として進化していくことが期待されます。その簡便さと拡張性は、AIテクノロジーをより身近なものにする大きな一歩と言えるでしょう。
まとめ:ローカルLLMの可能性を広げるために
この記事では、Ollamaを使ってローカル環境でLLMを動かす方法について詳しく解説してきました。最後に、ローカルLLMの可能性をさらに広げるためのポイントをまとめてみましょう。
ローカルLLMの魅力再確認
ローカルでLLMを動かす最大の魅力は、プライバシーとカスタマイズ性にあります。データがローカル環境から出ることがないため、機密情報を安心して処理できます。また、自分のニーズに合わせてモデルや応答パラメータを自由に調整できる柔軟性も大きな強みです。
Ollamaを使えば、わずか数行のコマンドで高性能なLLMをローカルで実行できます。これは数年前には考えられなかったことです。AIの力を誰もが使えるようになりつつある現在、ローカルLLMはその重要な一翼を担っています。
実践のためのステップ
ローカルLLMを実際に活用するために、以下のステップを参考にしてください:
まずは小さく始める:初めは小規模なモデル(Gemma 2BやMistral 7Bなど)から試し、経験を積みながら徐々に大きなモデルに移行するとよいでしょう。
ユースケースを明確にする:「何のために」LLMを使うのかを明確にすることで、適切なモデル選択やパラメータ設定が可能になります。
継続的な学習と更新:LLM技術は急速に進化しています。定期的に新しいモデルやテクニックをチェックし、システムを更新していくことが重要です。
フィードバックループの構築:LLMの出力を評価し、継続的に改善するサイクルを作りましょう。特にビジネス用途では、品質管理のプロセスが欠かせません。
将来への展望
ローカルLLMの未来は明るいと言えます。現在のトレンドを見ると、以下のような発展が期待されます:
モデルの小型化と高性能化:より小さなモデルでも十分な性能を発揮するようになり、一般的なPCでも快適に動作するようになるでしょう。
専門領域モデルの増加:法律、医療、エンジニアリングなど、特定の分野に特化したモデルが増え、専門知識を持ったアシスタントとしての役割を果たすようになります。
マルチモーダル化:テキストだけでなく、画像や音声を扱えるローカルモデルが一般化し、より自然なインターフェースが実現するでしょう。
コミュニティの発展:オープンソースコミュニティの活動により、ツールの改良やドキュメントの充実、ベストプラクティスの共有が進むことが期待されます。
Rabilooの支援体制
Rabilooでは、ローカルLLMの導入や活用に関するコンサルティングサービスを提供しています。特に以下のような支援が可能です
ビジネスニーズに合わせたローカルLLMソリューションの設計
既存システムとの統合支援
パフォーマンス最適化とトラブルシューティング
カスタムアプリケーション開発
ローカルLLMの可能性を最大限に引き出し、ビジネスの成長を加速させるパートナーとして、Rabilooのサービスをぜひご検討ください。
最後に
テクノロジーの進化により、かつては大企業や研究機関だけが利用できたAI技術が、今や個人や中小企業でも手の届くものになりました。ローカルLLMはその最たる例です。
プライバシーを守りながら、AIの力を最大限に活用する—それがOllamaのような革新的なツールの真価です。この記事が、あなたのAIジャーニーの一助となれば幸いです。
ローカルLLMの世界に踏み出し、その可能性を探求してみてください。新たな発見と創造の扉が開かれることでしょう。
ローカルLLMの導入や活用について、ご質問やご相談がございましたら、お気軽にRabilooまでお問い合わせください。経験豊富な専門家が、あなたのビジネスに最適なソリューションをご提案いたします。